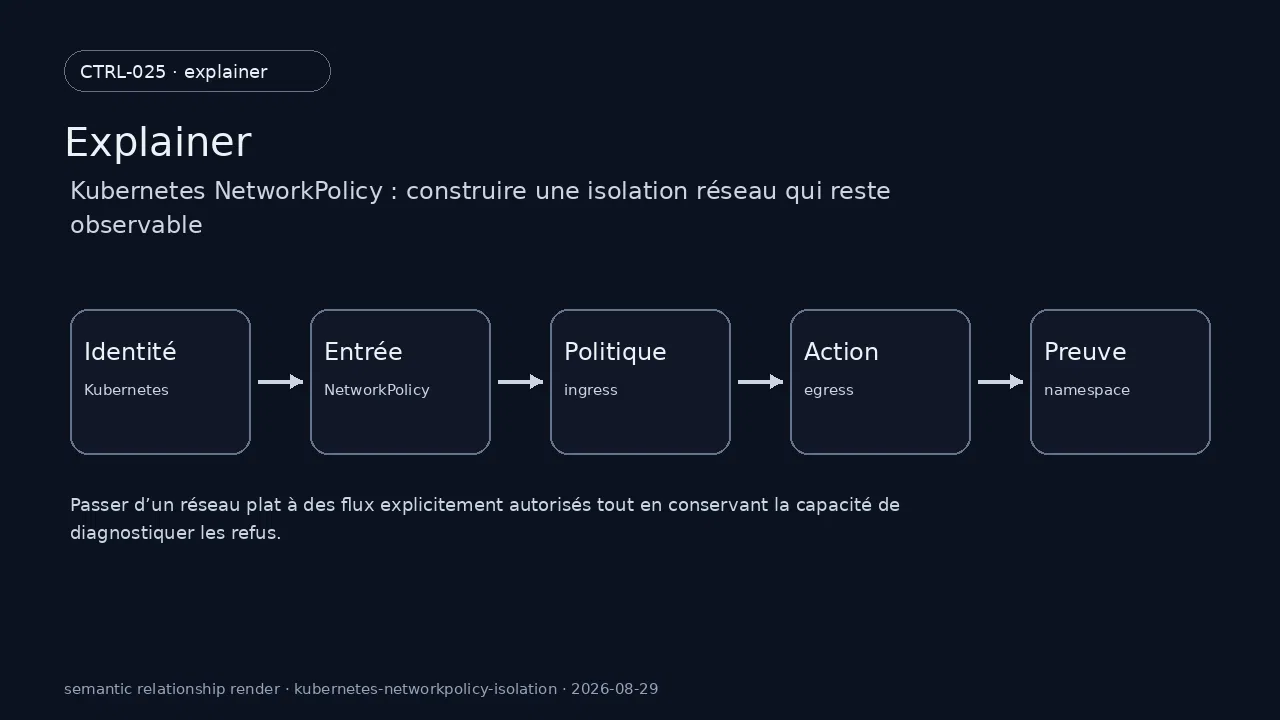
Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable répond à un problème précis : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Ce guide part des objets réels — Kubernetes, NetworkPolicy, ingress, egress, namespace — et cherche une décision vérifiable, pas une formule générique.
Le problème concret : Kubernetes face à NetworkPolicy
Le point de départ n’est pas une fonctionnalité, mais une frontière de décision observable.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c11 part de namespace et traite Kubernetes comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à NetworkPolicy de produire un résultat observable avant que ingress puisse déclencher l’effet attendu autour de egress. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme namespace en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester Kubernetes, la fixture kubernetes-networkpolicy-isolation-c11 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à NetworkPolicy. L’exploitation surveille alors la transition entre NetworkPolicy et ingress, tandis que la sécurité vérifie que egress ne reçoit ni autorité implicite ni donnée excédentaire.
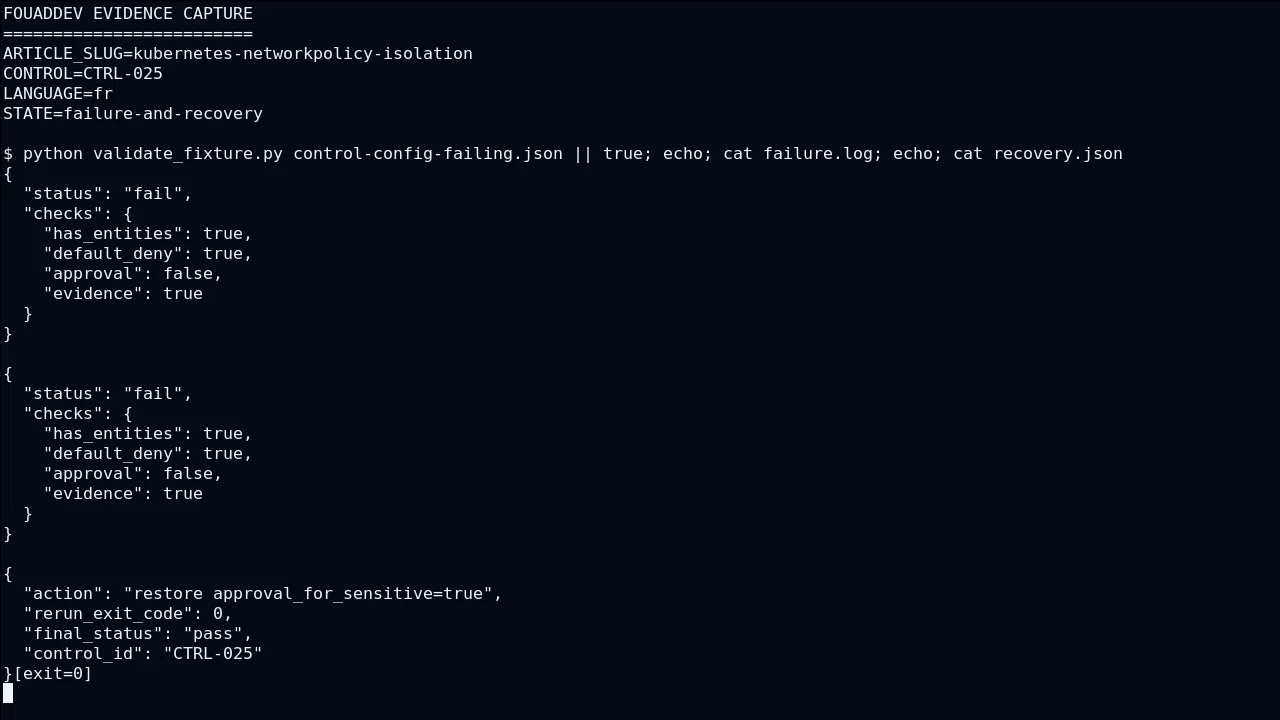
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c12 part de Kubernetes et traite NetworkPolicy comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à ingress de produire un résultat observable avant que egress puisse déclencher l’effet attendu autour de namespace. Si la vérification de egress échoue, le rollback restaure la configuration liée à namespace, rejoue kubernetes-networkpolicy-isolation-c12 et compare le nouvel état au témoin produit par Kubernetes. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à NetworkPolicy, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par ingress et namespace : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c12 est présenté comme limite ou hypothèse, jamais comme fait acquis.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c13 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme NetworkPolicy en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester ingress, la fixture kubernetes-networkpolicy-isolation-c13 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à egress. L’exploitation surveille alors la transition entre egress et namespace, tandis que la sécurité vérifie que Kubernetes ne reçoit ni autorité implicite ni donnée excédentaire.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c14 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. Si la vérification de Kubernetes échoue, le rollback restaure la configuration liée à NetworkPolicy, rejoue kubernetes-networkpolicy-isolation-c14 et compare le nouvel état au témoin produit par ingress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à egress, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par namespace et NetworkPolicy : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c14 est présenté comme limite ou hypothèse, jamais comme fait acquis.
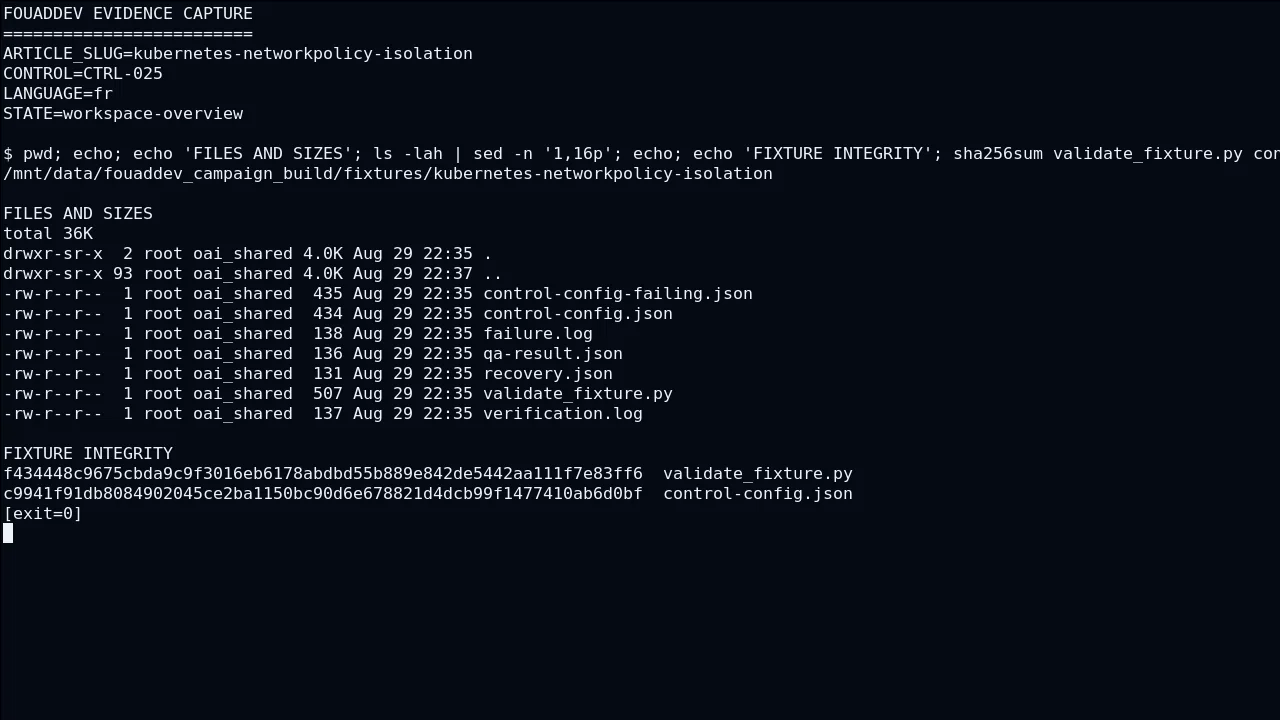
Frontières de confiance autour de ingress
Un système exploitable commence par une question simple : qui décide, sur quelles preuves, et que peut-on annuler ?
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c21 part de Kubernetes et traite NetworkPolicy comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à ingress de produire un résultat observable avant que egress puisse déclencher l’effet attendu autour de namespace. La décision finale reste bornée par ingress et namespace : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c21 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme Kubernetes en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester NetworkPolicy, la fixture kubernetes-networkpolicy-isolation-c21 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à ingress.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c22 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. L’exploitation surveille alors la transition entre egress et namespace, tandis que la sécurité vérifie que Kubernetes ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de namespace échoue, le rollback restaure la configuration liée à Kubernetes, rejoue kubernetes-networkpolicy-isolation-c22 et compare le nouvel état au témoin produit par NetworkPolicy. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à ingress, à une condition concrète et à une preuve plutôt qu’à une formule générale.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c23 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. La décision finale reste bornée par namespace et NetworkPolicy : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c23 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme ingress en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester egress, la fixture kubernetes-networkpolicy-isolation-c23 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à namespace.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c24 part de egress et traite namespace comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à Kubernetes de produire un résultat observable avant que NetworkPolicy puisse déclencher l’effet attendu autour de ingress. L’exploitation surveille alors la transition entre Kubernetes et NetworkPolicy, tandis que la sécurité vérifie que ingress ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de NetworkPolicy échoue, le rollback restaure la configuration liée à ingress, rejoue kubernetes-networkpolicy-isolation-c24 et compare le nouvel état au témoin produit par egress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à namespace, à une condition concrète et à une preuve plutôt qu’à une formule générale.
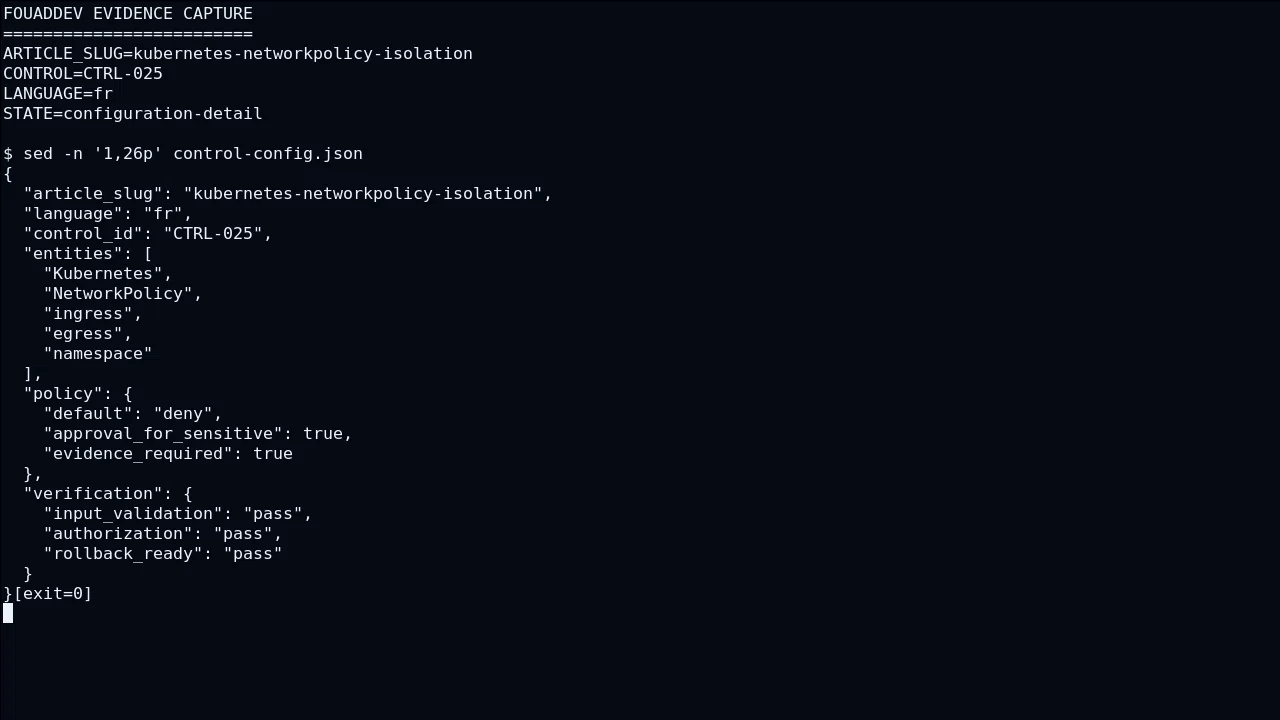
Construire le chemin de décision avec egress
La difficulté réelle apparaît lorsque le comportement nominal rencontre les droits, les erreurs et la production.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c31 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à ingress, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par egress et Kubernetes : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c31 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme NetworkPolicy en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c32 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. Pour tester egress, la fixture kubernetes-networkpolicy-isolation-c32 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à namespace. L’exploitation surveille alors la transition entre namespace et Kubernetes, tandis que la sécurité vérifie que NetworkPolicy ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de Kubernetes échoue, le rollback restaure la configuration liée à NetworkPolicy, rejoue kubernetes-networkpolicy-isolation-c32 et compare le nouvel état au témoin produit par ingress.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c33 part de egress et traite namespace comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à Kubernetes de produire un résultat observable avant que NetworkPolicy puisse déclencher l’effet attendu autour de ingress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à namespace, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par Kubernetes et ingress : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c33 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme egress en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c34 part de namespace et traite Kubernetes comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à NetworkPolicy de produire un résultat observable avant que ingress puisse déclencher l’effet attendu autour de egress. Pour tester Kubernetes, la fixture kubernetes-networkpolicy-isolation-c34 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à NetworkPolicy. L’exploitation surveille alors la transition entre NetworkPolicy et ingress, tandis que la sécurité vérifie que egress ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de ingress échoue, le rollback restaure la configuration liée à egress, rejoue kubernetes-networkpolicy-isolation-c34 et compare le nouvel état au témoin produit par namespace.
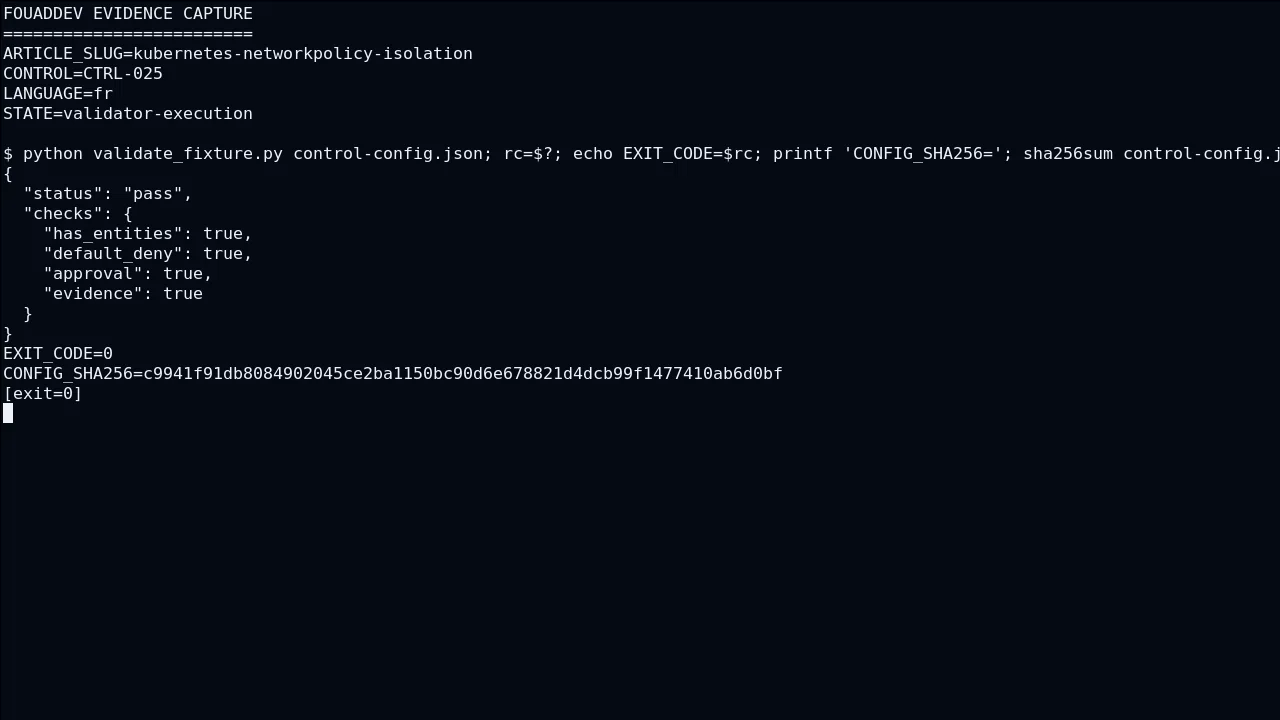
Vérifier le comportement de namespace
Le bon design sépare ce que le modèle propose de ce que l’application autorise et vérifie.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c41 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. Si la vérification de Kubernetes échoue, le rollback restaure la configuration liée à NetworkPolicy, rejoue kubernetes-networkpolicy-isolation-c41 et compare le nouvel état au témoin produit par ingress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à egress, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par namespace et NetworkPolicy : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c41 est présenté comme limite ou hypothèse, jamais comme fait acquis.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c42 part de egress et traite namespace comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à Kubernetes de produire un résultat observable avant que NetworkPolicy puisse déclencher l’effet attendu autour de ingress. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme egress en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester namespace, la fixture kubernetes-networkpolicy-isolation-c42 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à Kubernetes. L’exploitation surveille alors la transition entre Kubernetes et NetworkPolicy, tandis que la sécurité vérifie que ingress ne reçoit ni autorité implicite ni donnée excédentaire.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c43 part de namespace et traite Kubernetes comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à NetworkPolicy de produire un résultat observable avant que ingress puisse déclencher l’effet attendu autour de egress. Si la vérification de ingress échoue, le rollback restaure la configuration liée à egress, rejoue kubernetes-networkpolicy-isolation-c43 et compare le nouvel état au témoin produit par namespace. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à Kubernetes, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par NetworkPolicy et egress : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c43 est présenté comme limite ou hypothèse, jamais comme fait acquis.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c44 part de Kubernetes et traite NetworkPolicy comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à ingress de produire un résultat observable avant que egress puisse déclencher l’effet attendu autour de namespace. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme Kubernetes en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester NetworkPolicy, la fixture kubernetes-networkpolicy-isolation-c44 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à ingress. L’exploitation surveille alors la transition entre ingress et egress, tandis que la sécurité vérifie que namespace ne reçoit ni autorité implicite ni donnée excédentaire.
Échecs plausibles, signaux et diagnostic
Le point de départ n’est pas une fonctionnalité, mais une frontière de décision observable.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c51 part de egress et traite namespace comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à Kubernetes de produire un résultat observable avant que NetworkPolicy puisse déclencher l’effet attendu autour de ingress. L’exploitation surveille alors la transition entre Kubernetes et NetworkPolicy, tandis que la sécurité vérifie que ingress ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de NetworkPolicy échoue, le rollback restaure la configuration liée à ingress, rejoue kubernetes-networkpolicy-isolation-c51 et compare le nouvel état au témoin produit par egress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à namespace, à une condition concrète et à une preuve plutôt qu’à une formule générale.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c52 part de namespace et traite Kubernetes comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à NetworkPolicy de produire un résultat observable avant que ingress puisse déclencher l’effet attendu autour de egress. La décision finale reste bornée par NetworkPolicy et egress : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c52 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme namespace en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester Kubernetes, la fixture kubernetes-networkpolicy-isolation-c52 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à NetworkPolicy.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c53 part de Kubernetes et traite NetworkPolicy comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à ingress de produire un résultat observable avant que egress puisse déclencher l’effet attendu autour de namespace. L’exploitation surveille alors la transition entre ingress et egress, tandis que la sécurité vérifie que namespace ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de egress échoue, le rollback restaure la configuration liée à namespace, rejoue kubernetes-networkpolicy-isolation-c53 et compare le nouvel état au témoin produit par Kubernetes. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à NetworkPolicy, à une condition concrète et à une preuve plutôt qu’à une formule générale.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c54 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. La décision finale reste bornée par egress et Kubernetes : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c54 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme NetworkPolicy en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester ingress, la fixture kubernetes-networkpolicy-isolation-c54 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à egress.
Déploiement progressif et retour arrière
Un système exploitable commence par une question simple : qui décide, sur quelles preuves, et que peut-on annuler ?
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c61 part de namespace et traite Kubernetes comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à NetworkPolicy de produire un résultat observable avant que ingress puisse déclencher l’effet attendu autour de egress. Pour tester Kubernetes, la fixture kubernetes-networkpolicy-isolation-c61 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à NetworkPolicy. L’exploitation surveille alors la transition entre NetworkPolicy et ingress, tandis que la sécurité vérifie que egress ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de ingress échoue, le rollback restaure la configuration liée à egress, rejoue kubernetes-networkpolicy-isolation-c61 et compare le nouvel état au témoin produit par namespace.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c62 part de Kubernetes et traite NetworkPolicy comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à ingress de produire un résultat observable avant que egress puisse déclencher l’effet attendu autour de namespace. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à NetworkPolicy, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par ingress et namespace : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c62 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme Kubernetes en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c63 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. Pour tester ingress, la fixture kubernetes-networkpolicy-isolation-c63 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à egress. L’exploitation surveille alors la transition entre egress et namespace, tandis que la sécurité vérifie que Kubernetes ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de namespace échoue, le rollback restaure la configuration liée à Kubernetes, rejoue kubernetes-networkpolicy-isolation-c63 et compare le nouvel état au témoin produit par NetworkPolicy.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c64 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à egress, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par namespace et NetworkPolicy : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c64 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme ingress en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver.
Critères de décision pour la production
La difficulté réelle apparaît lorsque le comportement nominal rencontre les droits, les erreurs et la production.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c71 part de Kubernetes et traite NetworkPolicy comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à ingress de produire un résultat observable avant que egress puisse déclencher l’effet attendu autour de namespace. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme Kubernetes en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester NetworkPolicy, la fixture kubernetes-networkpolicy-isolation-c71 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à ingress. L’exploitation surveille alors la transition entre ingress et egress, tandis que la sécurité vérifie que namespace ne reçoit ni autorité implicite ni donnée excédentaire.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c72 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. Si la vérification de namespace échoue, le rollback restaure la configuration liée à Kubernetes, rejoue kubernetes-networkpolicy-isolation-c72 et compare le nouvel état au témoin produit par NetworkPolicy. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à ingress, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par egress et Kubernetes : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c72 est présenté comme limite ou hypothèse, jamais comme fait acquis.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c73 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme ingress en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester egress, la fixture kubernetes-networkpolicy-isolation-c73 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à namespace. L’exploitation surveille alors la transition entre namespace et Kubernetes, tandis que la sécurité vérifie que NetworkPolicy ne reçoit ni autorité implicite ni donnée excédentaire.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c74 part de egress et traite namespace comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à Kubernetes de produire un résultat observable avant que NetworkPolicy puisse déclencher l’effet attendu autour de ingress. Si la vérification de NetworkPolicy échoue, le rollback restaure la configuration liée à ingress, rejoue kubernetes-networkpolicy-isolation-c74 et compare le nouvel état au témoin produit par egress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à namespace, à une condition concrète et à une preuve plutôt qu’à une formule générale. La décision finale reste bornée par Kubernetes et ingress : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c74 est présenté comme limite ou hypothèse, jamais comme fait acquis.
Élément de preuve : Oracle documente que mySQL exposes security-relevant server options including local_infile, secure_file_priv, skip_networking and related controls. Cette source est utilisée ici pour cadrer critères de décision pour la production, pas pour remplacer le test local. [S7]Contrôles à conserver après la mise en service
Le bon design sépare ce que le modèle propose de ce que l’application autorise et vérifie.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c81 part de NetworkPolicy et traite ingress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à egress de produire un résultat observable avant que namespace puisse déclencher l’effet attendu autour de Kubernetes. La décision finale reste bornée par egress et Kubernetes : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c81 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme NetworkPolicy en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester ingress, la fixture kubernetes-networkpolicy-isolation-c81 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à egress.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c82 part de ingress et traite egress comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à namespace de produire un résultat observable avant que Kubernetes puisse déclencher l’effet attendu autour de NetworkPolicy. L’exploitation surveille alors la transition entre namespace et Kubernetes, tandis que la sécurité vérifie que NetworkPolicy ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de Kubernetes échoue, le rollback restaure la configuration liée à NetworkPolicy, rejoue kubernetes-networkpolicy-isolation-c82 et compare le nouvel état au témoin produit par ingress. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à egress, à une condition concrète et à une preuve plutôt qu’à une formule générale.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c83 part de egress et traite namespace comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à Kubernetes de produire un résultat observable avant que NetworkPolicy puisse déclencher l’effet attendu autour de ingress. La décision finale reste bornée par Kubernetes et ingress : ce qui n’est pas démontré par le scénario kubernetes-networkpolicy-isolation-c83 est présenté comme limite ou hypothèse, jamais comme fait acquis. Cette séquence répond au besoin suivant : Passer d’un réseau plat à des flux explicitement autorisés tout en conservant la capacité de diagnostiquer les refus. Elle transforme egress en point de décision vérifiable, avec une entrée nommée et une sortie que l’équipe peut conserver. Pour tester namespace, la fixture kubernetes-networkpolicy-isolation-c83 inclut volontairement un état valide et un état refusé ; le refus doit arriver avant toute modification attribuée à Kubernetes.
Dans « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable », le scénario kubernetes-networkpolicy-isolation-c84 part de namespace et traite Kubernetes comme une frontière explicite plutôt que comme une hypothèse implicite. Le premier contrôle demande à NetworkPolicy de produire un résultat observable avant que ingress puisse déclencher l’effet attendu autour de egress. L’exploitation surveille alors la transition entre NetworkPolicy et ingress, tandis que la sécurité vérifie que egress ne reçoit ni autorité implicite ni donnée excédentaire. Si la vérification de ingress échoue, le rollback restaure la configuration liée à egress, rejoue kubernetes-networkpolicy-isolation-c84 et compare le nouvel état au témoin produit par namespace. Ce niveau de détail rend « Kubernetes NetworkPolicy : construire une isolation réseau qui reste observable » révisable : chaque affirmation opérationnelle renvoie à Kubernetes, à une condition concrète et à une preuve plutôt qu’à une formule générale.
Élément de preuve : GitHub documente que gitHub Actions OIDC lets workflows obtain cloud access without storing long-lived cloud credentials, provided trust conditions constrain token issuance. Cette source est utilisée ici pour cadrer contrôles à conserver après la mise en service, pas pour remplacer le test local. [S8]Checklist opérationnelle
- Le contrôle autour de Kubernetes a une entrée, une règle, un refus et une preuve.
- Le contrôle autour de NetworkPolicy a une entrée, une règle, un refus et une preuve.
- Le contrôle autour de ingress a une entrée, une règle, un refus et une preuve.
- Le contrôle autour de egress a une entrée, une règle, un refus et une preuve.
- Le contrôle autour de namespace a une entrée, une règle, un refus et une preuve.
Sources et points de contrôle
- [S1] REST Security Cheat Sheet — OWASP REST guidance emphasizes HTTPS, explicit access control and careful handling of tokens, methods, inputs and security headers. source
- [S2] Policies - Kubernetes — Kubernetes policy objects include NetworkPolicies for traffic controls and admission mechanisms for validating or mutating API requests. source
- [S3] Security Checklist - Kubernetes — Kubernetes publishes a baseline security checklist while warning that cluster security requires ongoing context-specific attention rather than checklist compliance alone. source
- [S4] Application Security Checklist - Kubernetes — Kubernetes application guidance covers secure workload practices from the developer perspective. source
- [S5] Enforce Pod Security Standards by Configuring the Built-in Admission Controller — Pod Security Admission can enforce privileged, baseline or restricted policy levels and supports warn and audit modes for staged adoption. source
- [S6] MySQL 8.4 Security Components and Plugins — MySQL provides pluggable security components for authentication, password validation, key storage, auditing and firewall capabilities. source
- [S7] MySQL 8.4 Security Options and Variables — MySQL exposes security-relevant server options including local_infile, secure_file_priv, skip_networking and related controls. source
- [S8] Configuring OpenID Connect in cloud providers — GitHub Actions OIDC lets workflows obtain cloud access without storing long-lived cloud credentials, provided trust conditions constrain token issuance. source
- [S9] OpenID Connect reference - GitHub Docs — GitHub documents OIDC token claims such as issuer, audience and subject that cloud trust policies can evaluate. source
- [S10] Secure use reference - GitHub Actions — GitHub recommends pinning third-party actions to full-length commit SHAs to obtain an immutable reference. source


Commentaires
Aucun commentaire publié pour le moment.
Connectez-vous pour commenter