Prioriser les vulnérabilités par exploitabilité et impact métier répond à un problème opérationnel précis : transformer une intention en comportement vérifiable, sans masquer les compromis de sécurité, de qualité et d’exploitation. Ce guide progresse des fondations vers les choix experts, en utilisant file de correction croisant exposition, criticité et preuves d’exploitation comme fil conducteur et en confrontant les décisions aux contraintes de production.
Objectif, résultat attendu et périmètre
Prioriser les vulnérabilités par exploitabilité et impact métier devient un sujet d’ingénierie dès que le système doit rester fiable au-delà d’une démonstration. Le point de départ n’est pas l’outil, mais la décision à protéger : qui agit, sur quelles données, avec quelle autorité, et comment prouver après coup ce qui s’est passé. Ici, l’angle central est risk-based vulnerability management. L’exemple fil rouge est file de correction croisant exposition, criticité et preuves d’exploitation. Il permet de raisonner sur une situation concrète plutôt que sur une architecture abstraite.
Une conception robuste sépare intention, état, exécution et preuve. L’intention décrit le résultat métier attendu; l’état indique ce que le système sait réellement; l’exécution réalise une action limitée; la preuve rend cette action vérifiable. Dans Prioriser les vulnérabilités par exploitabilité et impact métier, cette séparation évite qu’une erreur locale devienne une incohérence globale. Elle facilite aussi les tests, car chaque frontière possède un contrat observable et une responsabilité identifiable.
Le niveau débutant doit comprendre le flux nominal, mais la production impose d’examiner les écarts : entrée ambiguë, donnée absente, ressource indisponible, reprise réseau, doublon, permission insuffisante ou résultat contradictoire. Chaque cas doit avoir une réponse prévue. Le bon comportement n’est pas toujours « réessayer » : parfois il faut refuser, mettre en attente, demander une validation ou conserver l’état pour une reprise idempotente.
À un niveau intermédiaire, on transforme ces règles en interfaces explicites. Les entrées sont validées avant l’appel d’un composant sensible; les sorties sont contrôlées avant d’être persistées ou propagées; les dépendances externes sont encapsulées. Cette discipline réduit le couplage et rend possible une évolution progressive. Une équipe peut remplacer une implémentation sans réécrire tout le parcours métier, à condition que le contrat reste stable et testé.

Prérequis et état de départ
Le niveau avancé concerne l’observabilité et la maîtrise du risque. Les journaux doivent porter des identifiants de corrélation, un contexte minimal utile, la décision prise et la cause d’un échec sans exposer inutilement de données sensibles. Les métriques et traces ne remplacent pas le raisonnement métier : elles doivent répondre à des questions opérationnelles précises, par exemple savoir où le flux s’est interrompu et si une reprise est sûre.
En pratique, file de correction croisant exposition, criticité et preuves d’exploitation doit être testable de bout en bout. On prépare un cas nominal, un cas de données incomplètes, un refus d’autorisation, une indisponibilité d’une dépendance et une répétition de la même requête. Le résultat attendu est défini avant l’exécution du test. Cette méthode transforme les exigences en preuves et évite les validations uniquement visuelles ou basées sur l’absence d’exception.
Le compromis principal oppose souvent simplicité immédiate et contrôlabilité future. Ajouter une couche, une file d’attente, un garde-fou ou une étape humaine a un coût. Ce coût est justifié lorsque l’échec est difficile à détecter, coûteux à corriger ou susceptible d’affecter des personnes, des données ou des opérations critiques. À l’inverse, multiplier les composants sans risque correspondant augmente la surface de panne et la charge cognitive.
Un piège expert consiste à confondre automatisation et autonomie. Automatiser une séquence connue ne signifie pas déléguer une décision ouverte. Pour Prioriser les vulnérabilités par exploitabilité et impact métier, il faut définir ce qui peut être exécuté automatiquement, ce qui exige une politique déterministe et ce qui doit être confirmé par un humain. Cette classification doit apparaître dans le code, les tests et les procédures d’exploitation, pas seulement dans une documentation générale.
Résultat attendu. Après chaque étape importante, le système doit produire un état vérifiable : succès explicite, attente explicite ou erreur classée. Aucun échec ne doit être transformé silencieusement en succès.
Étape 1 — établir les frontières et les responsabilités
La revue de production doit donc rechercher des preuves concrètes : contrats versionnés, tests de régression, gestion des erreurs, contrôle des privilèges, journalisation exploitable, stratégie de reprise et propriétaire clairement nommé. Une fonctionnalité peut sembler correcte en démonstration et rester non exploitable si l’équipe ne sait pas diagnostiquer un échec ou revenir à un état cohérent.
Enfin, la qualité se mesure à la capacité du système à rendre ses décisions compréhensibles. Un opérateur doit pouvoir distinguer un refus volontaire d’une panne, une attente d’une perte de donnée, et une reprise légitime d’un doublon. Cette lisibilité opérationnelle est un résultat d’architecture. Elle réduit le temps de diagnostic et empêche les corrections manuelles de masquer un défaut structurel.
Prioriser les vulnérabilités par exploitabilité et impact métier devient un sujet d’ingénierie dès que le système doit rester fiable au-delà d’une démonstration. Le point de départ n’est pas l’outil, mais la décision à protéger : qui agit, sur quelles données, avec quelle autorité, et comment prouver après coup ce qui s’est passé. Ici, l’angle central est risk-based vulnerability management. L’exemple fil rouge est file de correction croisant exposition, criticité et preuves d’exploitation. Il permet de raisonner sur une situation concrète plutôt que sur une architecture abstraite.
Une conception robuste sépare intention, état, exécution et preuve. L’intention décrit le résultat métier attendu; l’état indique ce que le système sait réellement; l’exécution réalise une action limitée; la preuve rend cette action vérifiable. Dans Prioriser les vulnérabilités par exploitabilité et impact métier, cette séparation évite qu’une erreur locale devienne une incohérence globale. Elle facilite aussi les tests, car chaque frontière possède un contrat observable et une responsabilité identifiable.
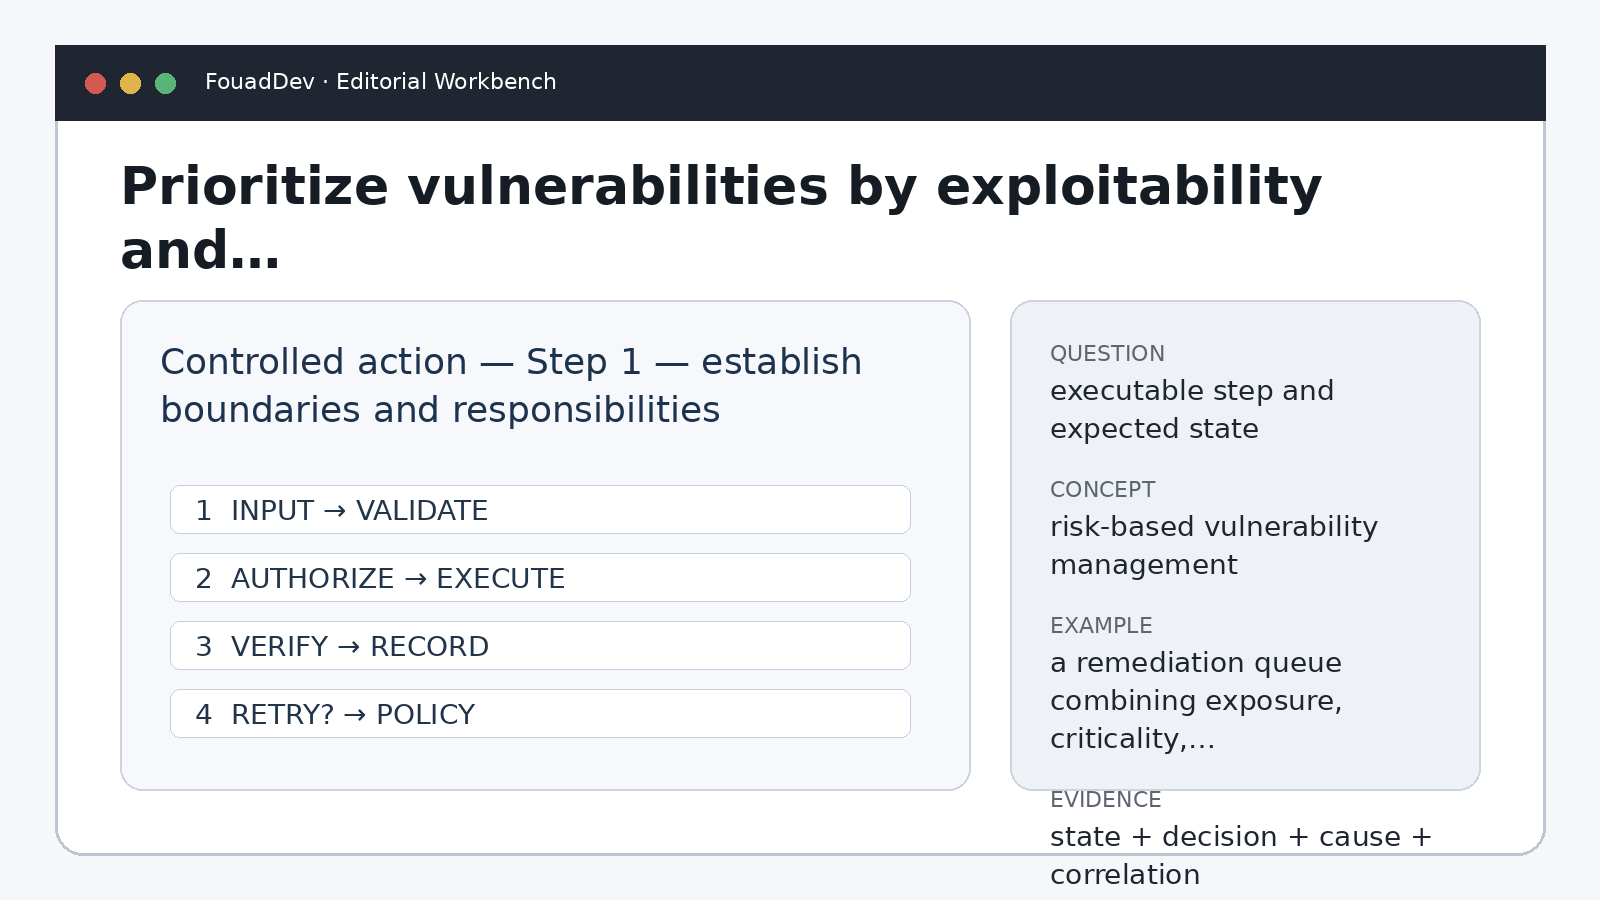
Étape 2 — implémenter le chemin nominal
Le niveau débutant doit comprendre le flux nominal, mais la production impose d’examiner les écarts : entrée ambiguë, donnée absente, ressource indisponible, reprise réseau, doublon, permission insuffisante ou résultat contradictoire. Chaque cas doit avoir une réponse prévue. Le bon comportement n’est pas toujours « réessayer » : parfois il faut refuser, mettre en attente, demander une validation ou conserver l’état pour une reprise idempotente.
À un niveau intermédiaire, on transforme ces règles en interfaces explicites. Les entrées sont validées avant l’appel d’un composant sensible; les sorties sont contrôlées avant d’être persistées ou propagées; les dépendances externes sont encapsulées. Cette discipline réduit le couplage et rend possible une évolution progressive. Une équipe peut remplacer une implémentation sans réécrire tout le parcours métier, à condition que le contrat reste stable et testé.
Le niveau avancé concerne l’observabilité et la maîtrise du risque. Les journaux doivent porter des identifiants de corrélation, un contexte minimal utile, la décision prise et la cause d’un échec sans exposer inutilement de données sensibles. Les métriques et traces ne remplacent pas le raisonnement métier : elles doivent répondre à des questions opérationnelles précises, par exemple savoir où le flux s’est interrompu et si une reprise est sûre.
En pratique, file de correction croisant exposition, criticité et preuves d’exploitation doit être testable de bout en bout. On prépare un cas nominal, un cas de données incomplètes, un refus d’autorisation, une indisponibilité d’une dépendance et une répétition de la même requête. Le résultat attendu est défini avant l’exécution du test. Cette méthode transforme les exigences en preuves et évite les validations uniquement visuelles ou basées sur l’absence d’exception.
Commande ou action de départ. Commencez par écrire l’état initial de file de correction croisant exposition, criticité et preuves d’exploitation. Listez les entrées nécessaires, le propriétaire de chaque donnée et l’action autorisée. Ne codez pas une reprise tant que vous ne savez pas distinguer un nouvel ordre d’une répétition.
Étape 3 — gérer erreurs, reprises et sécurité
Le compromis principal oppose souvent simplicité immédiate et contrôlabilité future. Ajouter une couche, une file d’attente, un garde-fou ou une étape humaine a un coût. Ce coût est justifié lorsque l’échec est difficile à détecter, coûteux à corriger ou susceptible d’affecter des personnes, des données ou des opérations critiques. À l’inverse, multiplier les composants sans risque correspondant augmente la surface de panne et la charge cognitive.
Un piège expert consiste à confondre automatisation et autonomie. Automatiser une séquence connue ne signifie pas déléguer une décision ouverte. Pour Prioriser les vulnérabilités par exploitabilité et impact métier, il faut définir ce qui peut être exécuté automatiquement, ce qui exige une politique déterministe et ce qui doit être confirmé par un humain. Cette classification doit apparaître dans le code, les tests et les procédures d’exploitation, pas seulement dans une documentation générale.
La revue de production doit donc rechercher des preuves concrètes : contrats versionnés, tests de régression, gestion des erreurs, contrôle des privilèges, journalisation exploitable, stratégie de reprise et propriétaire clairement nommé. Une fonctionnalité peut sembler correcte en démonstration et rester non exploitable si l’équipe ne sait pas diagnostiquer un échec ou revenir à un état cohérent.
Enfin, la qualité se mesure à la capacité du système à rendre ses décisions compréhensibles. Un opérateur doit pouvoir distinguer un refus volontaire d’une panne, une attente d’une perte de donnée, et une reprise légitime d’un doublon. Cette lisibilité opérationnelle est un résultat d’architecture. Elle réduit le temps de diagnostic et empêche les corrections manuelles de masquer un défaut structurel.
Vérification et tests reproductibles
Prioriser les vulnérabilités par exploitabilité et impact métier devient un sujet d’ingénierie dès que le système doit rester fiable au-delà d’une démonstration. Le point de départ n’est pas l’outil, mais la décision à protéger : qui agit, sur quelles données, avec quelle autorité, et comment prouver après coup ce qui s’est passé. Ici, l’angle central est risk-based vulnerability management. L’exemple fil rouge est file de correction croisant exposition, criticité et preuves d’exploitation. Il permet de raisonner sur une situation concrète plutôt que sur une architecture abstraite.
Une conception robuste sépare intention, état, exécution et preuve. L’intention décrit le résultat métier attendu; l’état indique ce que le système sait réellement; l’exécution réalise une action limitée; la preuve rend cette action vérifiable. Dans Prioriser les vulnérabilités par exploitabilité et impact métier, cette séparation évite qu’une erreur locale devienne une incohérence globale. Elle facilite aussi les tests, car chaque frontière possède un contrat observable et une responsabilité identifiable.
Le niveau débutant doit comprendre le flux nominal, mais la production impose d’examiner les écarts : entrée ambiguë, donnée absente, ressource indisponible, reprise réseau, doublon, permission insuffisante ou résultat contradictoire. Chaque cas doit avoir une réponse prévue. Le bon comportement n’est pas toujours « réessayer » : parfois il faut refuser, mettre en attente, demander une validation ou conserver l’état pour une reprise idempotente.
À un niveau intermédiaire, on transforme ces règles en interfaces explicites. Les entrées sont validées avant l’appel d’un composant sensible; les sorties sont contrôlées avant d’être persistées ou propagées; les dépendances externes sont encapsulées. Cette discipline réduit le couplage et rend possible une évolution progressive. Une équipe peut remplacer une implémentation sans réécrire tout le parcours métier, à condition que le contrat reste stable et testé.
Test de contrôle. Répétez exactement la même opération avec le même identifiant de corrélation. Le résultat métier ne doit pas être dupliqué. Coupez ensuite une dépendance et vérifiez que l’état reste cohérent.
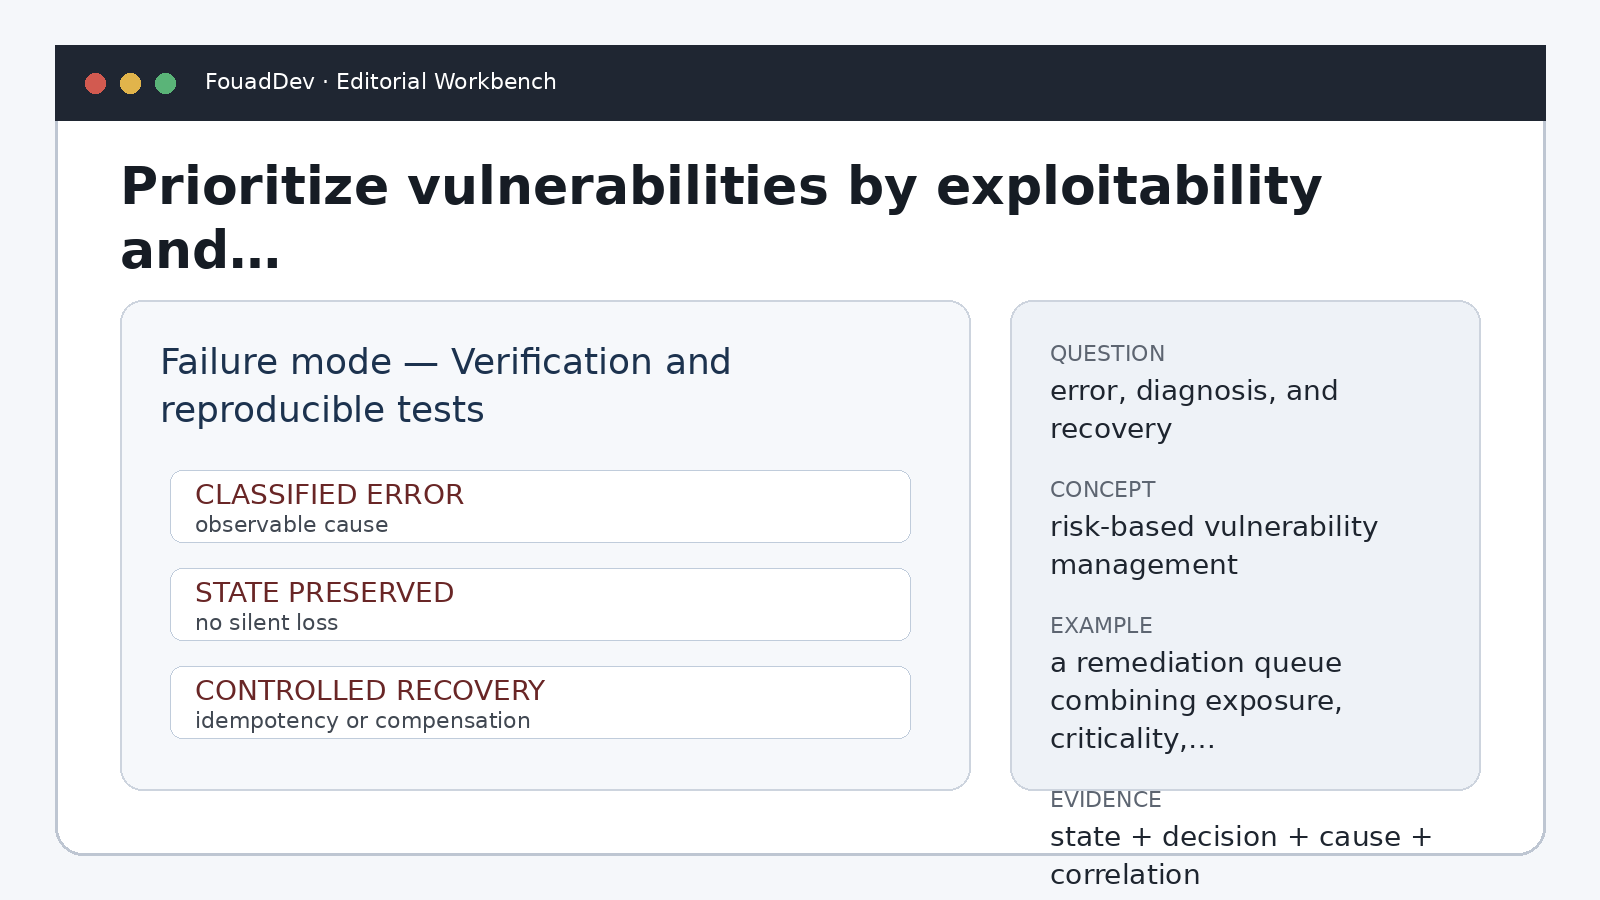
Dépannage des échecs fréquents
Le niveau avancé concerne l’observabilité et la maîtrise du risque. Les journaux doivent porter des identifiants de corrélation, un contexte minimal utile, la décision prise et la cause d’un échec sans exposer inutilement de données sensibles. Les métriques et traces ne remplacent pas le raisonnement métier : elles doivent répondre à des questions opérationnelles précises, par exemple savoir où le flux s’est interrompu et si une reprise est sûre.
En pratique, file de correction croisant exposition, criticité et preuves d’exploitation doit être testable de bout en bout. On prépare un cas nominal, un cas de données incomplètes, un refus d’autorisation, une indisponibilité d’une dépendance et une répétition de la même requête. Le résultat attendu est défini avant l’exécution du test. Cette méthode transforme les exigences en preuves et évite les validations uniquement visuelles ou basées sur l’absence d’exception.
Le compromis principal oppose souvent simplicité immédiate et contrôlabilité future. Ajouter une couche, une file d’attente, un garde-fou ou une étape humaine a un coût. Ce coût est justifié lorsque l’échec est difficile à détecter, coûteux à corriger ou susceptible d’affecter des personnes, des données ou des opérations critiques. À l’inverse, multiplier les composants sans risque correspondant augmente la surface de panne et la charge cognitive.
Un piège expert consiste à confondre automatisation et autonomie. Automatiser une séquence connue ne signifie pas déléguer une décision ouverte. Pour Prioriser les vulnérabilités par exploitabilité et impact métier, il faut définir ce qui peut être exécuté automatiquement, ce qui exige une politique déterministe et ce qui doit être confirmé par un humain. Cette classification doit apparaître dans le code, les tests et les procédures d’exploitation, pas seulement dans une documentation générale.
Durcissement pour la production
La revue de production doit donc rechercher des preuves concrètes : contrats versionnés, tests de régression, gestion des erreurs, contrôle des privilèges, journalisation exploitable, stratégie de reprise et propriétaire clairement nommé. Une fonctionnalité peut sembler correcte en démonstration et rester non exploitable si l’équipe ne sait pas diagnostiquer un échec ou revenir à un état cohérent.
Enfin, la qualité se mesure à la capacité du système à rendre ses décisions compréhensibles. Un opérateur doit pouvoir distinguer un refus volontaire d’une panne, une attente d’une perte de donnée, et une reprise légitime d’un doublon. Cette lisibilité opérationnelle est un résultat d’architecture. Elle réduit le temps de diagnostic et empêche les corrections manuelles de masquer un défaut structurel.
Prioriser les vulnérabilités par exploitabilité et impact métier devient un sujet d’ingénierie dès que le système doit rester fiable au-delà d’une démonstration. Le point de départ n’est pas l’outil, mais la décision à protéger : qui agit, sur quelles données, avec quelle autorité, et comment prouver après coup ce qui s’est passé. Ici, l’angle central est risk-based vulnerability management. L’exemple fil rouge est file de correction croisant exposition, criticité et preuves d’exploitation. Il permet de raisonner sur une situation concrète plutôt que sur une architecture abstraite.
Une conception robuste sépare intention, état, exécution et preuve. L’intention décrit le résultat métier attendu; l’état indique ce que le système sait réellement; l’exécution réalise une action limitée; la preuve rend cette action vérifiable. Dans Prioriser les vulnérabilités par exploitabilité et impact métier, cette séparation évite qu’une erreur locale devienne une incohérence globale. Elle facilite aussi les tests, car chaque frontière possède un contrat observable et une responsabilité identifiable.
Résultat attendu. Après chaque étape importante, le système doit produire un état vérifiable : succès explicite, attente explicite ou erreur classée. Aucun échec ne doit être transformé silencieusement en succès.
Variantes avancées et choix alternatifs
Le niveau débutant doit comprendre le flux nominal, mais la production impose d’examiner les écarts : entrée ambiguë, donnée absente, ressource indisponible, reprise réseau, doublon, permission insuffisante ou résultat contradictoire. Chaque cas doit avoir une réponse prévue. Le bon comportement n’est pas toujours « réessayer » : parfois il faut refuser, mettre en attente, demander une validation ou conserver l’état pour une reprise idempotente.
À un niveau intermédiaire, on transforme ces règles en interfaces explicites. Les entrées sont validées avant l’appel d’un composant sensible; les sorties sont contrôlées avant d’être persistées ou propagées; les dépendances externes sont encapsulées. Cette discipline réduit le couplage et rend possible une évolution progressive. Une équipe peut remplacer une implémentation sans réécrire tout le parcours métier, à condition que le contrat reste stable et testé.
Le niveau avancé concerne l’observabilité et la maîtrise du risque. Les journaux doivent porter des identifiants de corrélation, un contexte minimal utile, la décision prise et la cause d’un échec sans exposer inutilement de données sensibles. Les métriques et traces ne remplacent pas le raisonnement métier : elles doivent répondre à des questions opérationnelles précises, par exemple savoir où le flux s’est interrompu et si une reprise est sûre.
En pratique, file de correction croisant exposition, criticité et preuves d’exploitation doit être testable de bout en bout. On prépare un cas nominal, un cas de données incomplètes, un refus d’autorisation, une indisponibilité d’une dépendance et une répétition de la même requête. Le résultat attendu est défini avant l’exécution du test. Cette méthode transforme les exigences en preuves et évite les validations uniquement visuelles ou basées sur l’absence d’exception.
Test de contrôle. Répétez exactement la même opération avec le même identifiant de corrélation. Le résultat métier ne doit pas être dupliqué. Coupez ensuite une dépendance et vérifiez que l’état reste cohérent.
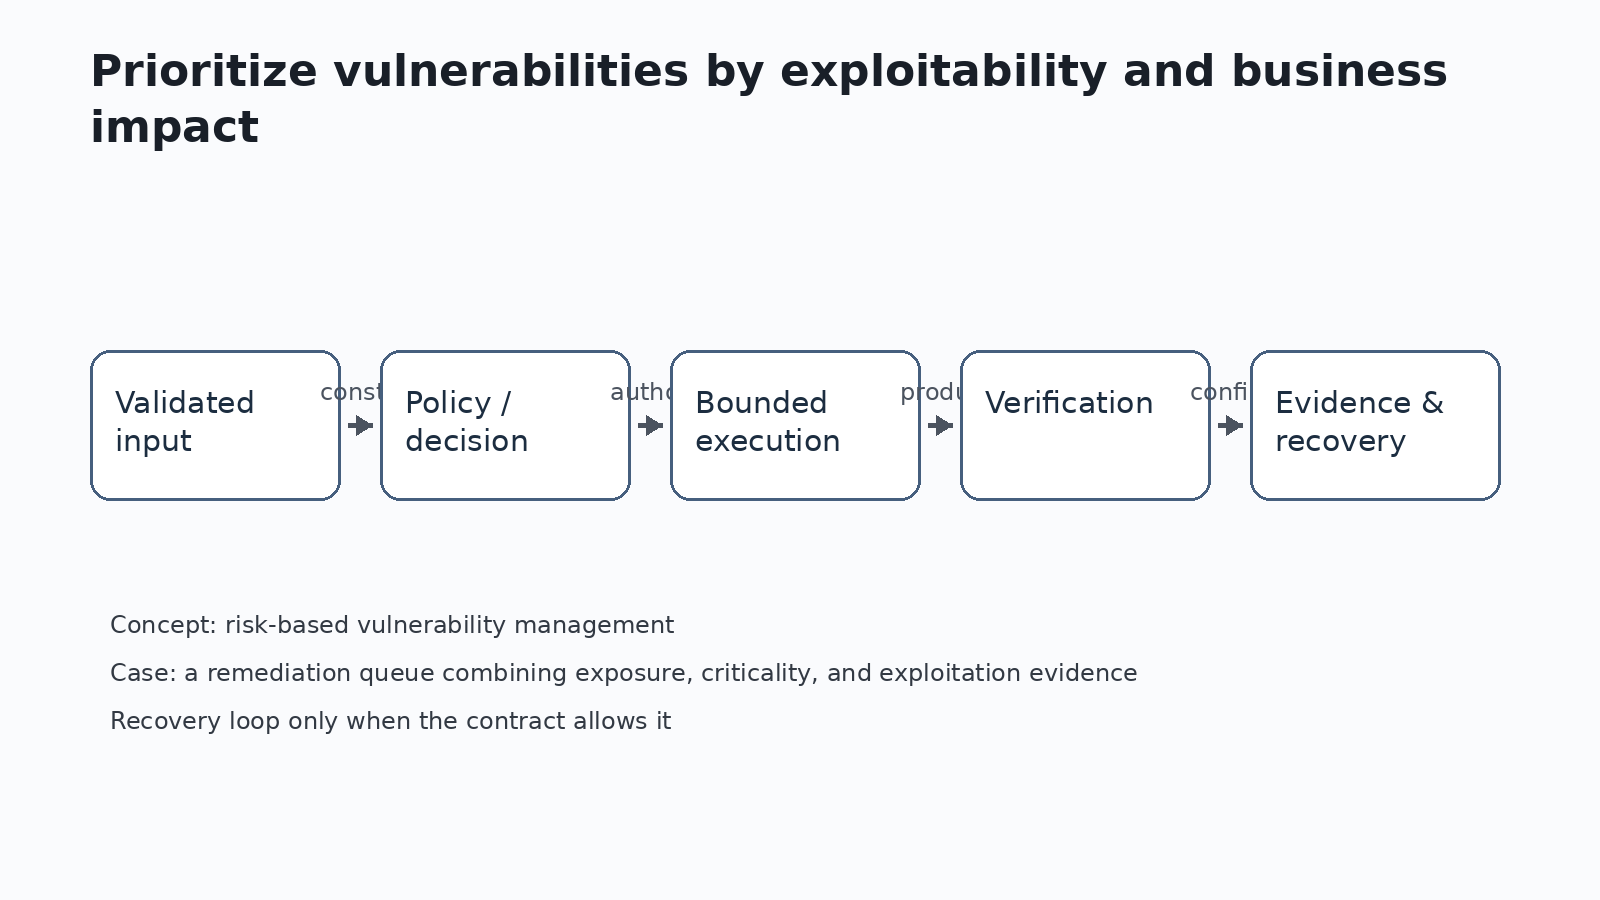
Checklist finale exécutable
Le compromis principal oppose souvent simplicité immédiate et contrôlabilité future. Ajouter une couche, une file d’attente, un garde-fou ou une étape humaine a un coût. Ce coût est justifié lorsque l’échec est difficile à détecter, coûteux à corriger ou susceptible d’affecter des personnes, des données ou des opérations critiques. À l’inverse, multiplier les composants sans risque correspondant augmente la surface de panne et la charge cognitive.
Un piège expert consiste à confondre automatisation et autonomie. Automatiser une séquence connue ne signifie pas déléguer une décision ouverte. Pour Prioriser les vulnérabilités par exploitabilité et impact métier, il faut définir ce qui peut être exécuté automatiquement, ce qui exige une politique déterministe et ce qui doit être confirmé par un humain. Cette classification doit apparaître dans le code, les tests et les procédures d’exploitation, pas seulement dans une documentation générale.
La revue de production doit donc rechercher des preuves concrètes : contrats versionnés, tests de régression, gestion des erreurs, contrôle des privilèges, journalisation exploitable, stratégie de reprise et propriétaire clairement nommé. Une fonctionnalité peut sembler correcte en démonstration et rester non exploitable si l’équipe ne sait pas diagnostiquer un échec ou revenir à un état cohérent.
Enfin, la qualité se mesure à la capacité du système à rendre ses décisions compréhensibles. Un opérateur doit pouvoir distinguer un refus volontaire d’une panne, une attente d’une perte de donnée, et une reprise légitime d’un doublon. Cette lisibilité opérationnelle est un résultat d’architecture. Elle réduit le temps de diagnostic et empêche les corrections manuelles de masquer un défaut structurel.
Commande ou action de départ. Commencez par écrire l’état initial de file de correction croisant exposition, criticité et preuves d’exploitation. Listez les entrées nécessaires, le propriétaire de chaque donnée et l’action autorisée. Ne codez pas une reprise tant que vous ne savez pas distinguer un nouvel ordre d’une répétition.


Commentaires
Aucun commentaire publié pour le moment.
Connectez-vous pour commenter